Для того чтобы сэкономить место на внешних носителях (жёстких дисках, флэш‐дисках) и ускорить передачу информации по компьютерным сетям, нужно ее сжать – уменьшить информационный объем, сократить длину двоичного кода. Это можно сделать, устранив избыточность использованного кода. Сжатие данных – сокращение объема данных при сохранении закодированного в них содержания.
Например, пусть текстовый файл объёмом 10 Кбайт содержит всего четырех различных символа: латинские буквы «А», «В», «С» и пробел. Д ля кодирования одного из четырёх возможных вариантов достаточно 2 битов, поэтому использовать для его передачи обычное 8-битное кодирование символов невыгодно. Можно присвоить каждому из четырёх символов двухбитные коды, например, так: А — 00, В — 01, С — 10, пробел — 11. Тогда последовательность «АВА САВАВА», занимающая 10 байтов в однобайтной кодировке, может быть представлена как цепочка из 20 битов: 00010011100001000100 Таким образом, нам удалось уменьшить информационный объём текста в 4 раза, и передаваться он будет в 4 раза быстрее
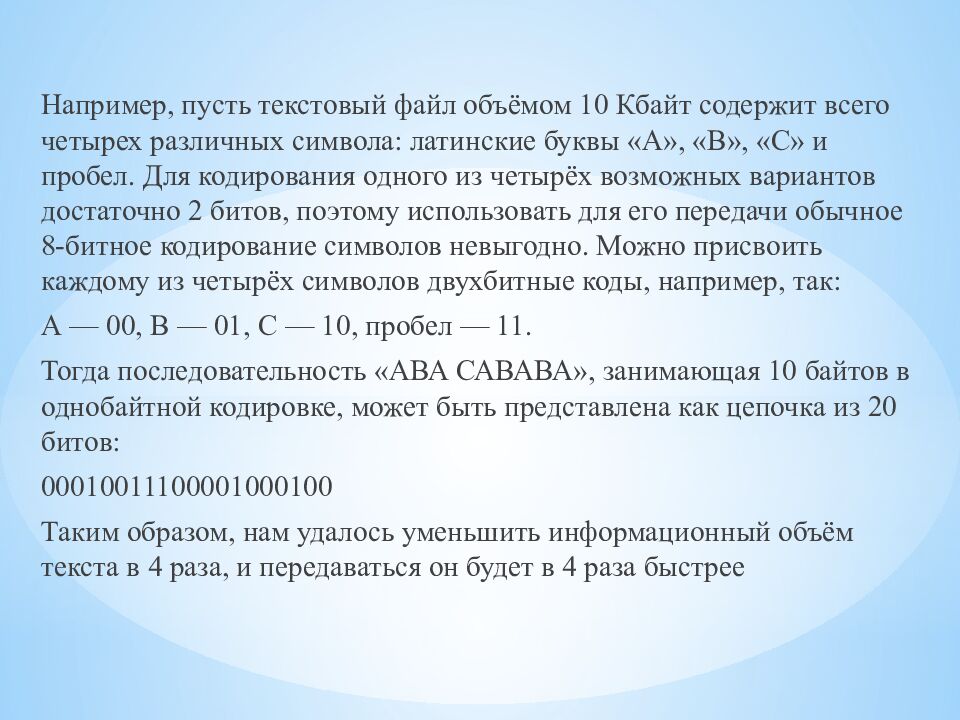
Однако непонятно, как раскодировать это сообщение, ведь получатель не знает, какой код был использован. Выход состоит в том, чтобы включить в сообщение служебную информацию — заголовок, в котором каждому коду будет сопоставлен ASCII- код символа. Условимся, что первый байт заголовка — это количество используемых символов N, а следующие N байтов — это ASCII- коды этих символов. В данном случае заголовок занимает 5 байтов и выглядит так: Файл, занимающий 10 Кбайт в 8-битной кодировке, содержит 10 240 символов. В сжатом виде каждый символ кодируется двумя битами, кроме того, есть 5-байтный заголовок. Поэтому сжатый файл будет иметь объём 5 + 10240 • 2/8 байтов = 2565 байтов.
Коэффициент сжатия — это отношение размеров исходного и сжатого файлов. В данном случае удалось сжать файл почти в 4 раза, коэффициент сжатия равен k = 10 240/2565 ≈ 4. Если принимающая сторона «знает» формат файла (заголовок + закодированные данные), она сможет восстановить в точности его исходный вид. Такое сжатие называют сжатием без потерь. Оно используется для упаковки текстов, программ, данных, которые ни в коем случае нельзя искажать. Сжатие без потерь — это такое уменьшение объёма закодированных данных, при котором можно восстановить их исходный вид из кода без искажений. За счёт чего удалось сжать файл? Только за счёт того, что в файле была некоторая закономерность, избыточность — использовались только 4 символа вместо полного набора.
Сжатие без потерь (полностью обратимое) – это такое уменьшение объёма закодированных данных, при котором можно восстановить их исходный вид из кода без искажений(может применяться для сжатия любой информации). Сжатие с регулируемыми потерями – это методы сжатия данных, при которых часть данных отбрасывается и не подлежит восстановлению ( используется для видео, звука, изображений) Сжатие информации Сжатие бывает без потерь и с потерями.
Алгоритм RLE Кодирование методом Хаффмана Схема сжатия LZW Арифметическое сжатие Сжатие без потерь
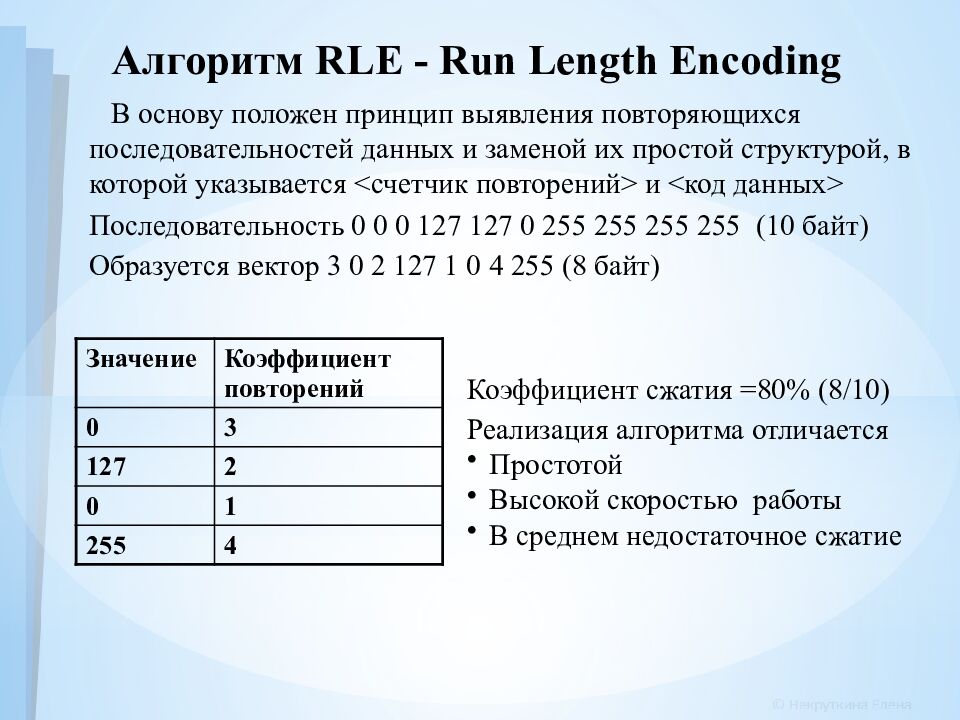
Значение Коэффициент повторений 0 3 127 2 0 1 255 4 Алгоритм RLE - Run Length Encoding В основу положен принцип выявления повторяющихся последовательностей данных и заменой их простой структурой, в которой указывается < счетчик повторений > и < код данных > Последовательность 0 0 0 127 127 0 255 255 255 255 (10 байт) Образуется вектор 3 0 2 127 1 0 4 255 (8 байт) Коэффициент сжатия =80% (8 /10 ) Реализация алгоритма отличается Простотой Высокой скоростью работы В среднем недостаточное сжатие
Очевидно, что такой подход будет приводить к увеличению (в 2 раза) объема данных в том случае, когда в файле нет соседних одинаковых символов. Чтобы улучшить результаты RLE-кодирования даже в этом наихудшем случае, алгоритм модифицировали следующим образом. Упакованная последовательность содержит управляющие байты, за каждым управляющим байтом следует один или несколько байтов данных. Если старший бит управляющего байта равен 1, то следующий за управляющим байт данных при распаковке нужно повторить столько раз, сколько записано в оставшихся 7 битах управляющего байта. Если же старший бит управляющего байта равен 0, то надо взять несколько следующих байтов данных без изменения. Сколько именно — записано в оставшихся 7 битах управляющего байта. Например, управляющий байт 10000111 2 говорит о том, что следующий за ним байт надо повторить 7 раз, а управляющий байт 00000100 2 — о том, что следующие за ним 4 байта надо взять без изменений. Например, последовательность 10001111 2 11000000 2 00000010 2 11000001 2 11000010 2 распаковывается в17 символов: ААААААААААААААБВ Повтор 15 А(код192) 2 Б(код 193) В(194)
Алгоритм RLE успешно использовался для сжатия рисунков, в которых большие области закрашены одним цветом, и некоторых звуковых данных. Сейчас вместо него применяют более совершенные, но более сложные методы. Алгоритм RLE используется, например, на одном из этапов кодирования рисунков в формате JPEG. Возможность использования RLE-сжатия есть также в формате BMP (для рисунков с палитрой 16 или 256 цветов).
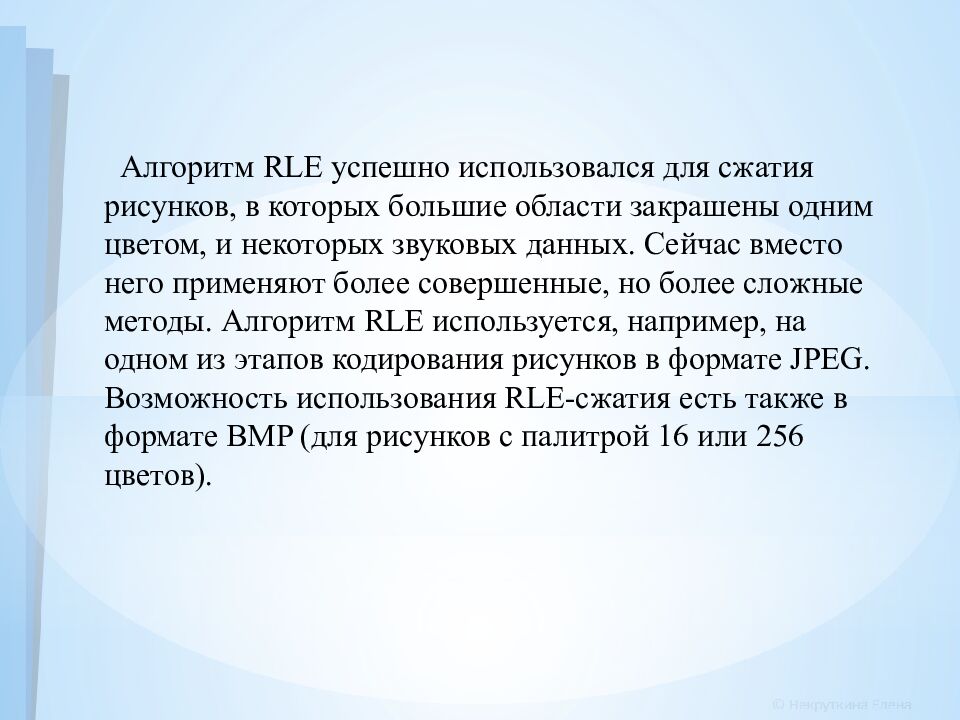
Задания. С помощью алгоритма RLE закодируйте сообщение «ВААААВАААРРРРРРРРРР» 2. После кодирования методом RLE получилась следующая последовательность байтов(первый байт-управляющий): 10000011 10101010 00000010 10101111 11111111 10000101 10101010 Сколько байтов будет содержать данная последовательность после распаковки ?
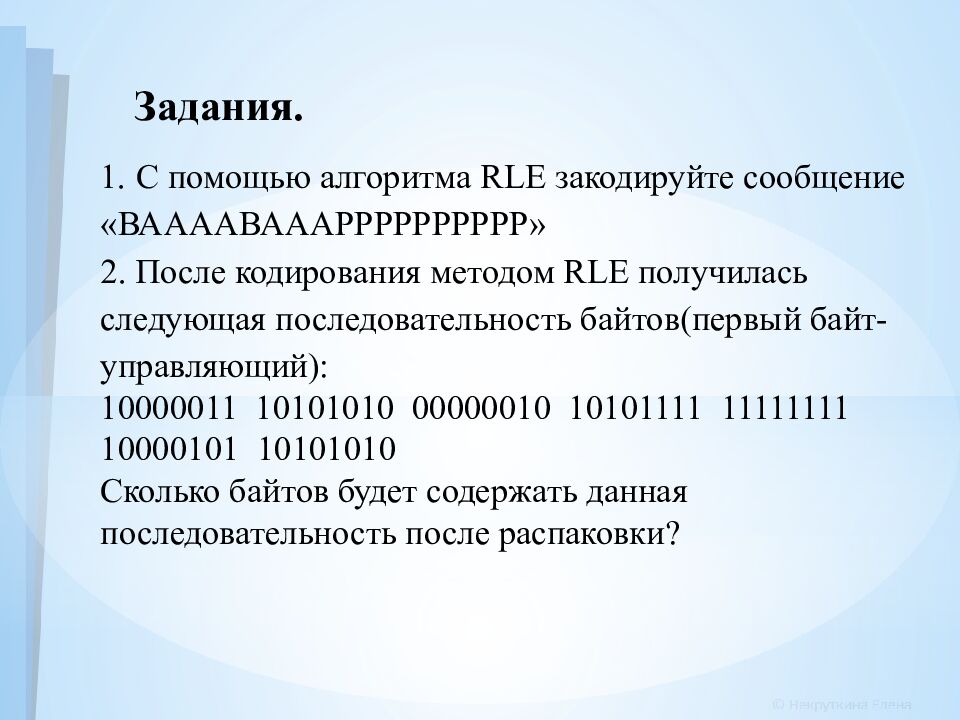
Префиксные коды В азбуке Морзе для уменьшения длины сообщения используется неравномерный код — часто встречающиеся буквы (А, Е, М, Н, Т) кодируются короткими последовательностями, а редко встречающиеся — более длинными. Такой код можно представить в виде структуры, которая называется деревом. На рисунке показано неполное дерево кода Морзе, построенное только для символов, коды которых состоят из одного и двух знаков (точек и тире). Дерево состоит из узлов (большая чёрная точка и кружки с символами алфавита) и соединяющих их направленных рёбер, стрелки указывают направление движения. Верхний узел (в который не входит ни одна стрелка) называется корнем дерева. Из корня и из всех промежуточных узлов (кроме конечных узлов — листьев ) выходят две стрелки, левая помечена точкой, а правая — знаком «тире». По этому дереву можно построить такие кодовые слова:
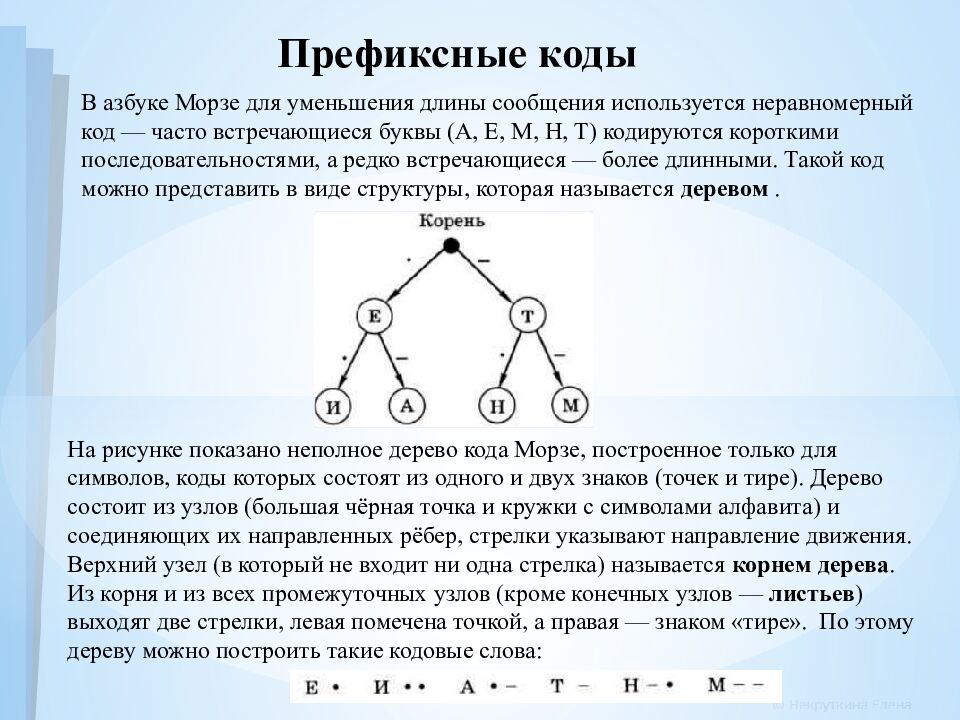
Это неравномерный код, в нём символы имеют коды разной длины. При этом всегда возникает проблема разделения последовательности на отдельные кодовые слова. В коде Морзе она решена с помощью символа-разделителя — паузы. Однако можно не вводить дополнительный символ, если выполняется условие Фано : ни одно из кодовых слов не является началом другого кодового слова. Это позволяет однозначно раскодировать сообщение в реальном времени, по мере получения очередных символов. Префиксный код - это код, в котором ни одно кодовое слово не является началом другого кодового слова (условие Фано).
Для использования этой идеи в компьютерной обработке данных нужно было разработать алгоритм построения префиксного кода. Впервые эту задачу решили, независимо друг от друга, американские математики и инженеры Клод Шеннон и Роберт Фано ( код Шеннона-Фано ).
Они использовали избыточность сообщений, состоящую в том, что символы в тексте имеют разные частоты встречаемости. В этом случае для построения кода нужно читать данные исходного файла два раза: на первом проходе определяется частота встречаемости каждого символа, затем строится код с учётом этих данных, и на втором проходе символы текста заменяются на их коды. Пусть, например, текст состоит только из букв «О», «Е», «Н», «Т» и пробела. Известно, сколько раз они встретились в тексте: пробел — 179, О — 89, Е — 72, Н — 53 и Т — 50 раз. Делим символы на 2 группы так, чтобы общее количество найденных в тексте символов первой группы было примерно равно общему количеству символов второй группы. В нашем случае лучший вариант — это объединить пробел и букву Т в первую группу (сумма 179 + 50 = 229), а остальные символы — во вторую (сумма 89 + 72 + 53 = 214).
Символы первой группы будут иметь коды, начинающиеся с 0, а остальные — с 1. В первой группе всего два символа, у одного из них, например у пробела, вторая цифра кода будет 0 (и полный код 00), а у второго — 1 (код буквы Т — 01). Во второй группе три символа, поэтому продолжаем деление на две группы, примерно равные по количеству символов в тексте. В первую выделяем одну букву, которая чаще всего встречается — это буква О (её код будет 10), а во вторую — буквы Е и Н (они получают коды 110 и 111). Код Шеннона-Фано, построенный для этого случая, можно нарисовать в виде дерева.
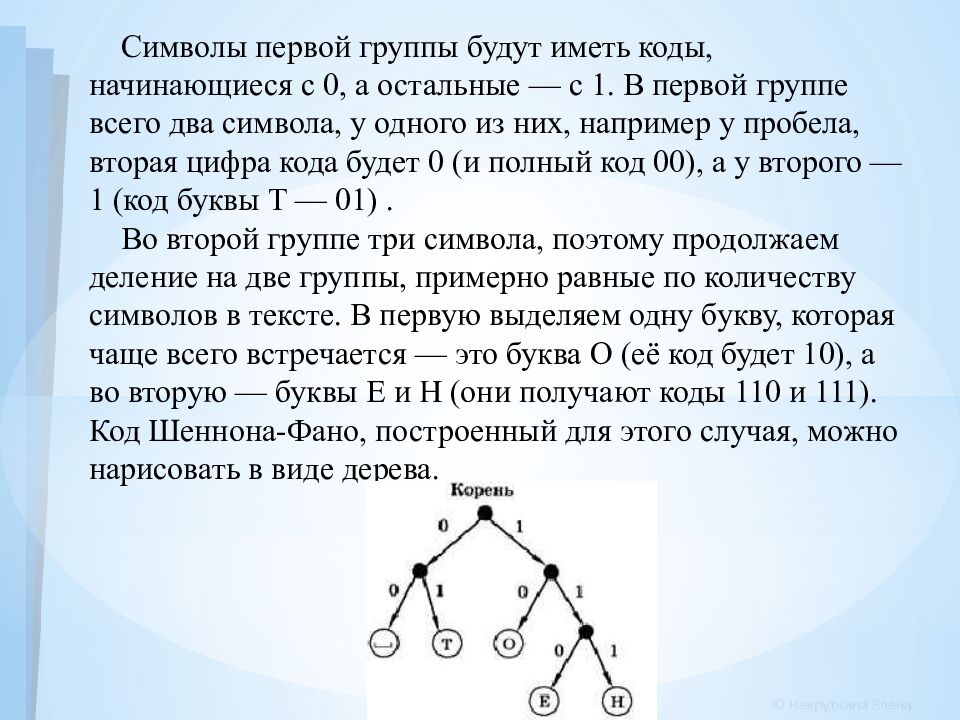
Легко проверить, что для этого кода выполняется условие Фано. Это можно сразу определить по построенному дереву. В нём все символы располагаются в листьях, а не в промежуточных узлах. Это значит, что «по пути» от корня дерева до любого символа никаких других символов в промежуточных узлах не встречается (сравните с деревом кода Морзе). Для раскодирования очередного символа последовательности спускаемся от корня дерева, выбирая левую ветку, если очередной бит — 0, и правую, если этот бит равен 1. Дойдя до листа дерева, мы определяем символ, а затем снова начинаем с корня дерева, чтобы раскодировать следующий символ, и т. д. Например, пусть получена последовательность 01100110001101111001 Результат ее раскодирования — «ТОТО ЕНОТ».
Задания. 1.Постройте дерево, соответствующее коду А - 0, Б - 1, В -00, Г - 01, Д - 10, Е - 11. Является ли код префиксным ? Как это определить посмотрев на дерево ? 2. Раскодируйте сообщение, которое закодировано с помощью приведённого в презентации кода Шеннона-Фано: 11111000011011111001001101111001
Было доказано, что в некоторых случаях кодирование Шеннона- Фано дает неоптимальное решение, и можно построить код, который ещё больше уменьшит длину кодовой последовательности. Через несколько лет Дэвид Хаффман, ученик Фано, разработал новый алгоритм кодирования и доказал его оптимальность. Алгоритм Хаффмана – адаптивный алгоритм оптимального префиксного кодирования алфавита с минимальной избыточностью.
Сжатие происходит за счет устранения избыточности кода, например, за счет упрощения кодов, исключения из них постоянных битов или представления повторяющихся символов в виде коэффициента повторения. Важнейшая характеристика процесса сжатия – коэффициент сжатия. Коэффициент сжатия – отношение объема исходного сообщения к объему сжатого.
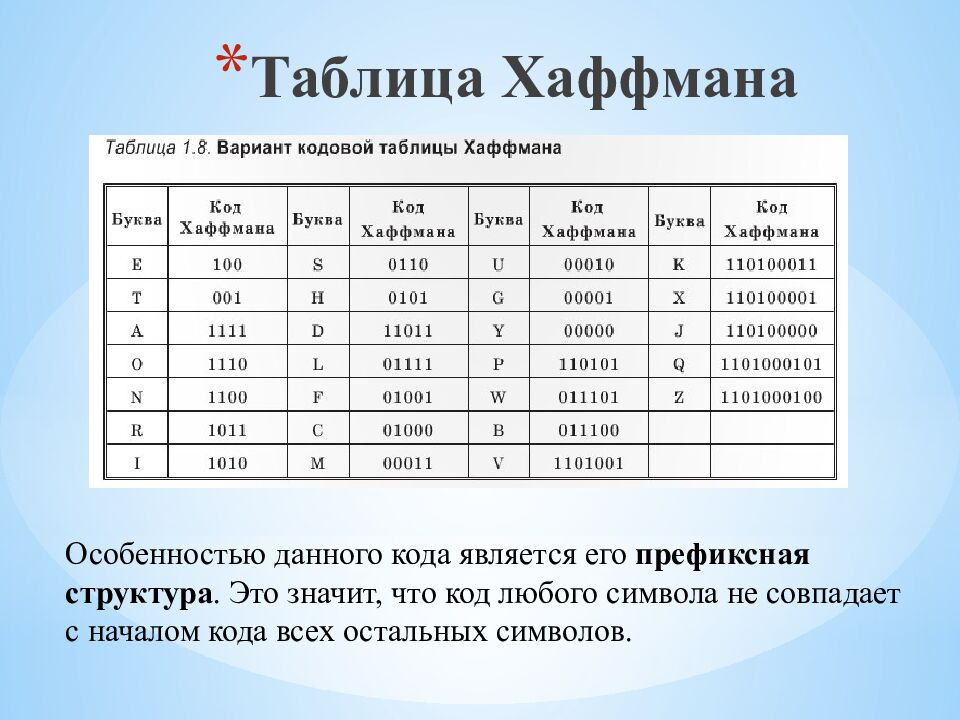
Особенностью данного кода является его префиксная структура. Это значит, что код любого символа не совпадает с началом кода всех остальных символов.
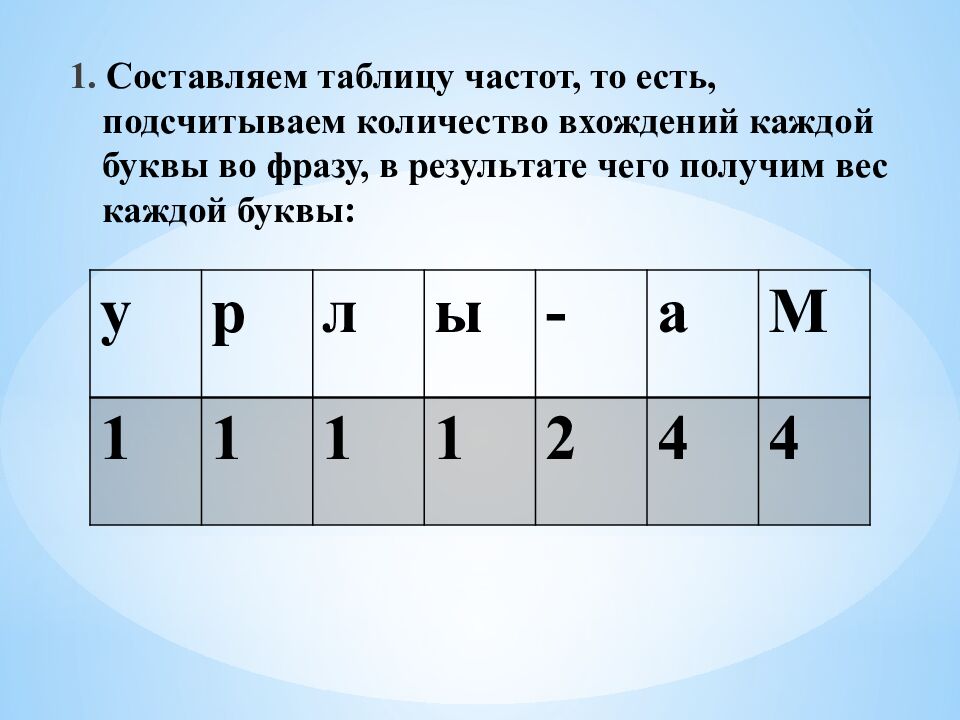
у р л ы - а М 1 1 1 1 2 4 4
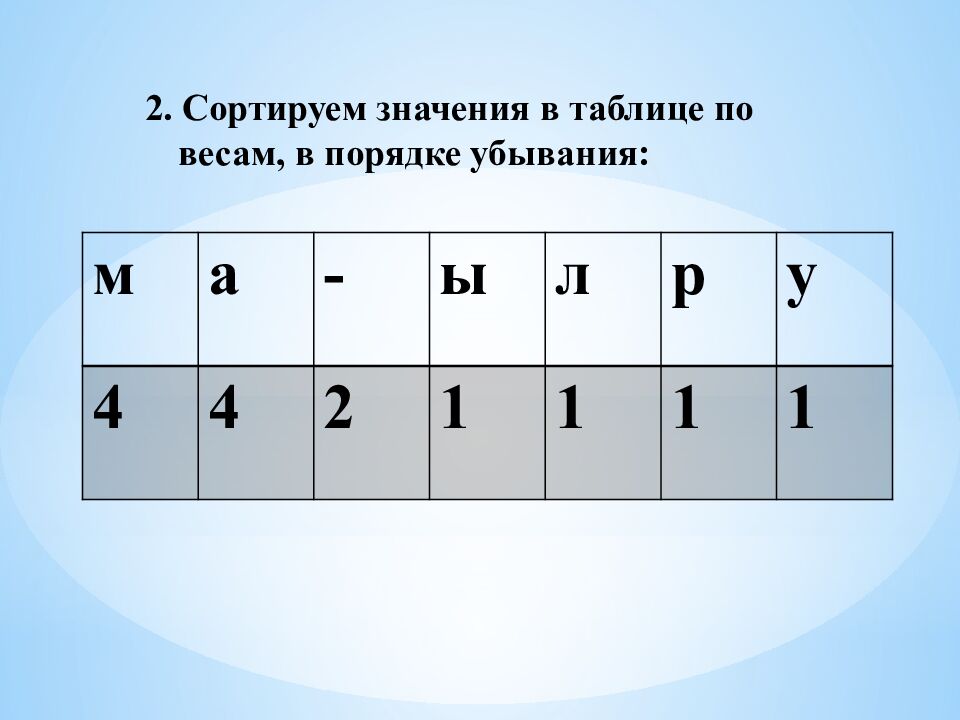
м а - ы л р у 4 4 2 1 1 1 1
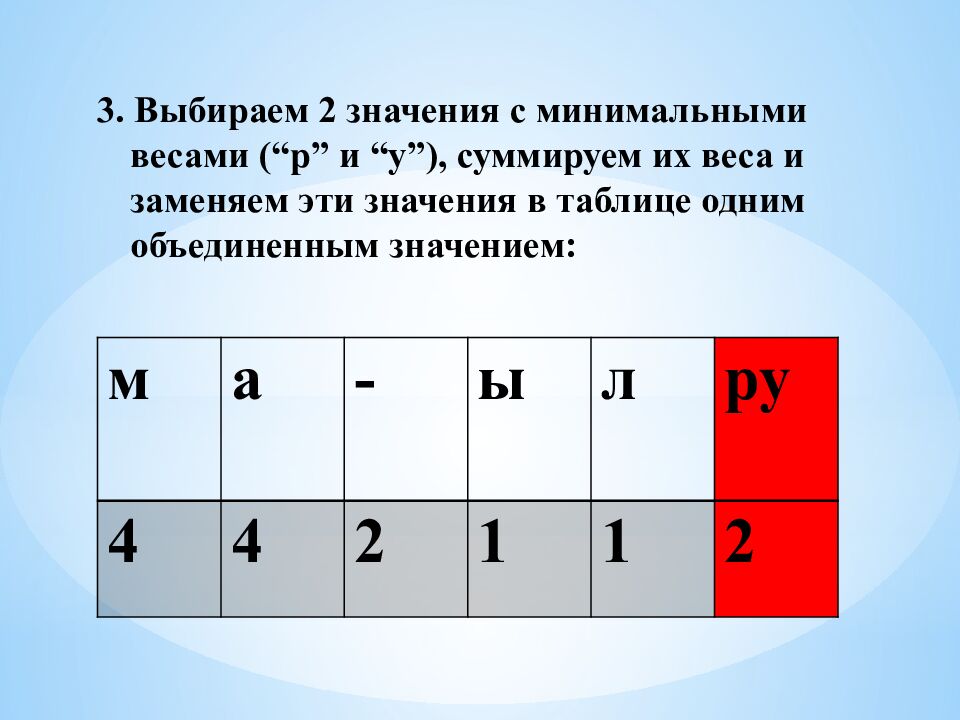
м а - ы л ру 4 4 2 1 1 2
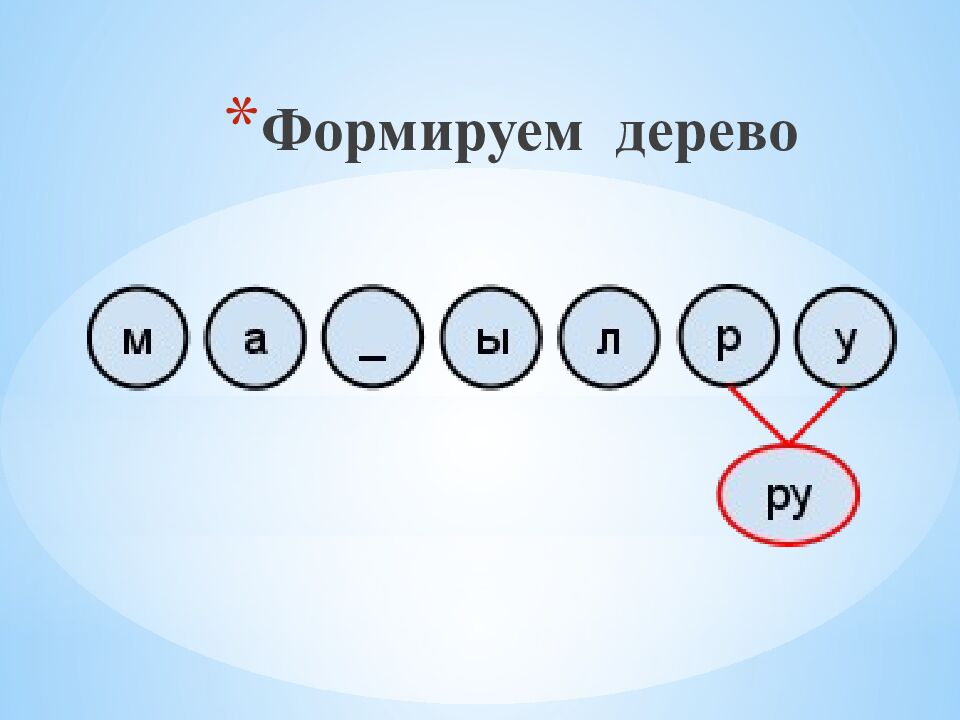
М А - ЫЛ РУ 4 4 2 2 2
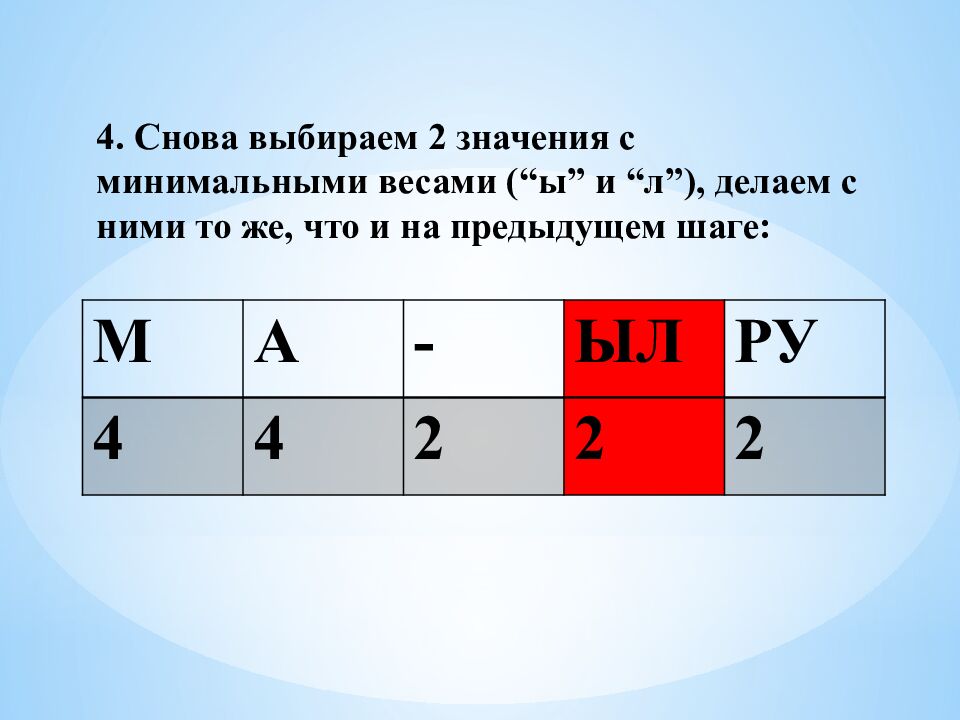
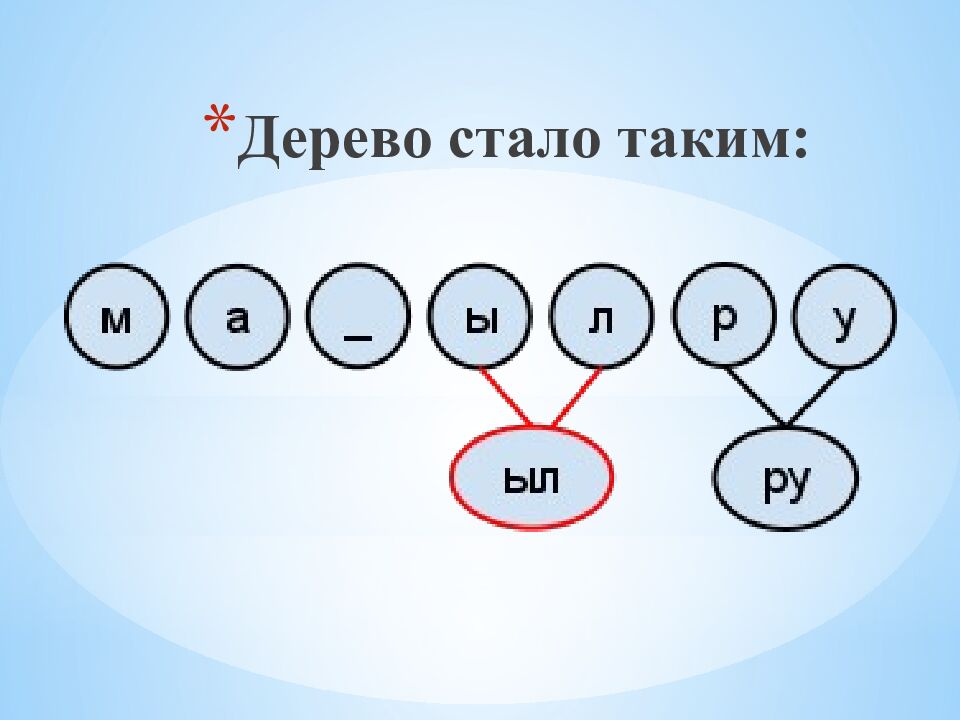
М Ф - ЫЛРУ 4 4 2 4
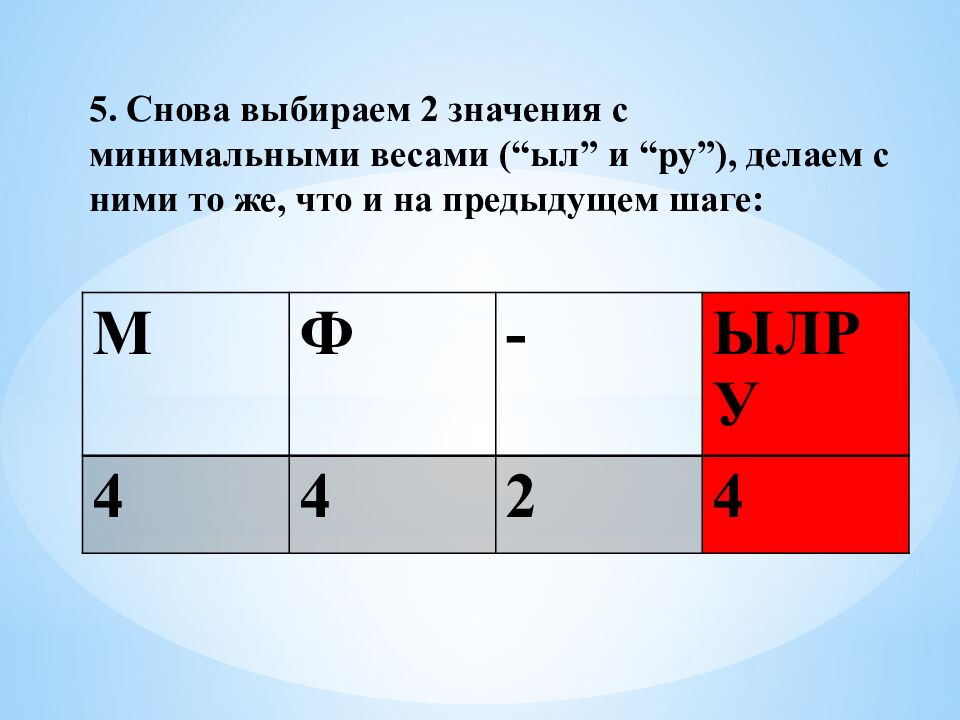
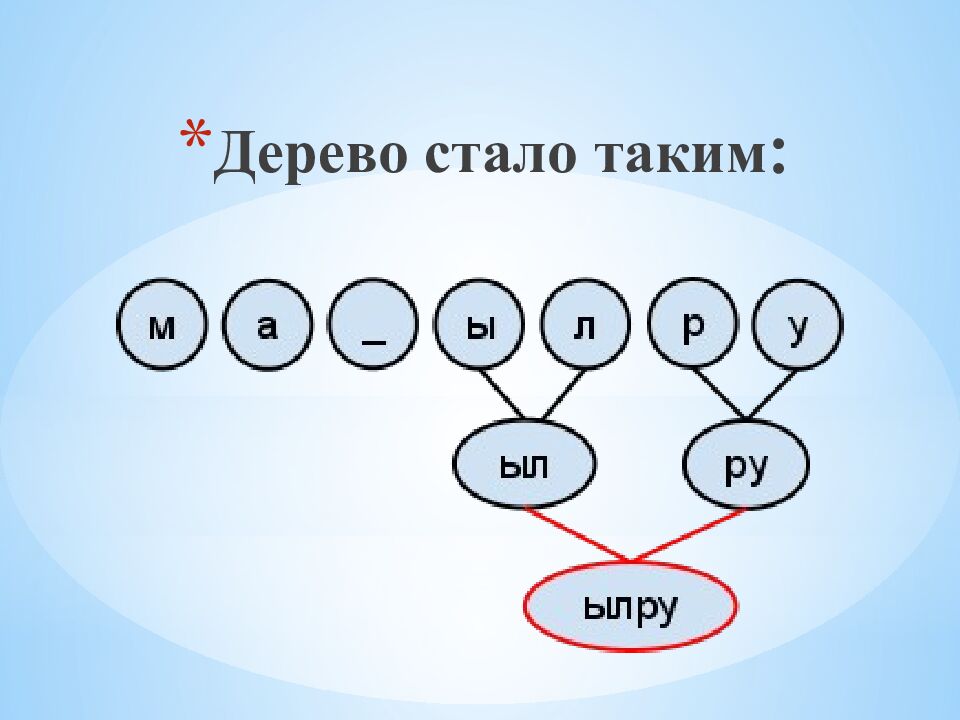
М А -ЫЛРУ 4 4 6
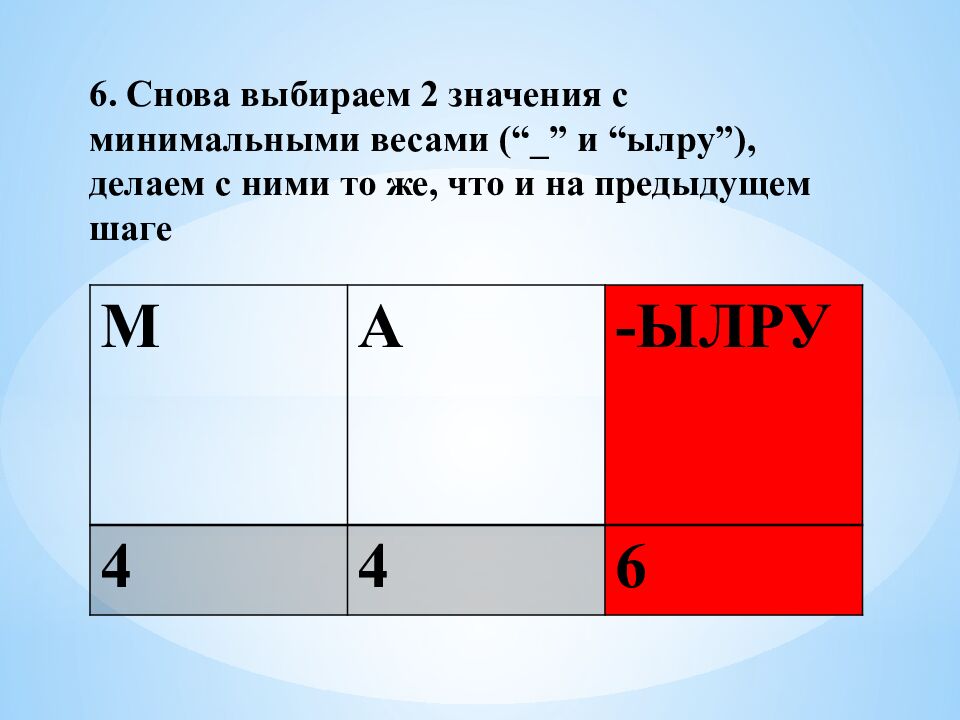
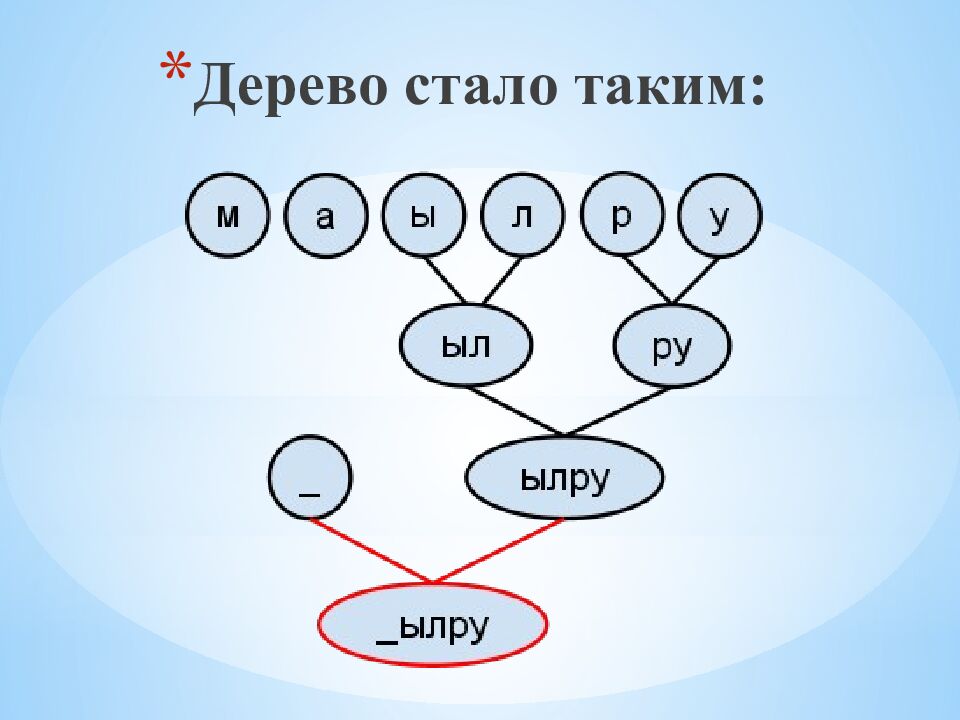
МА -ЫЛРУ 8 6
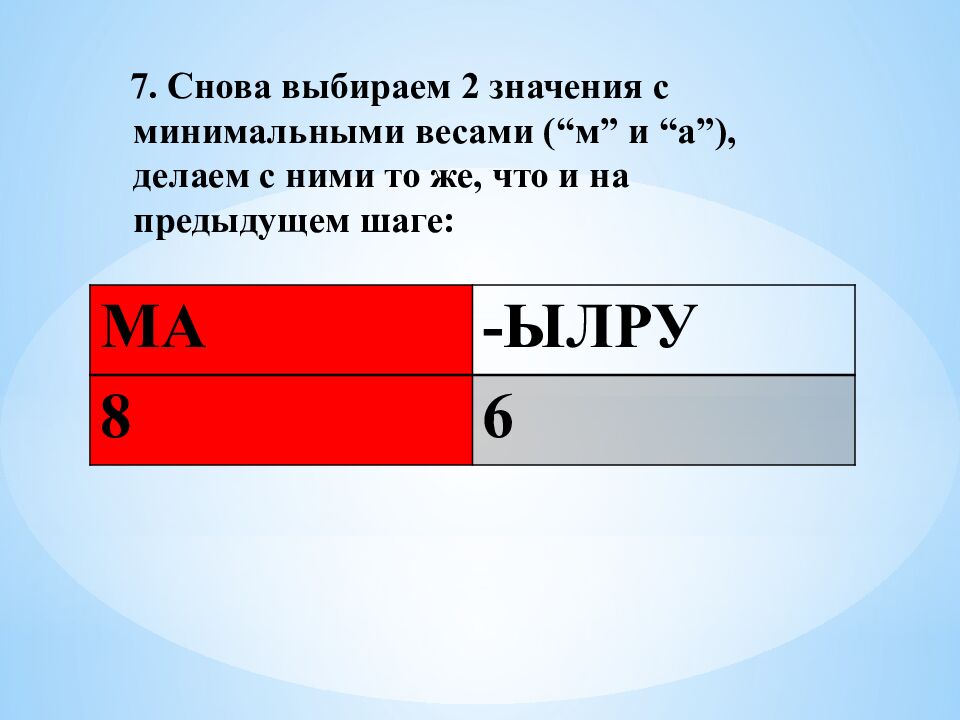
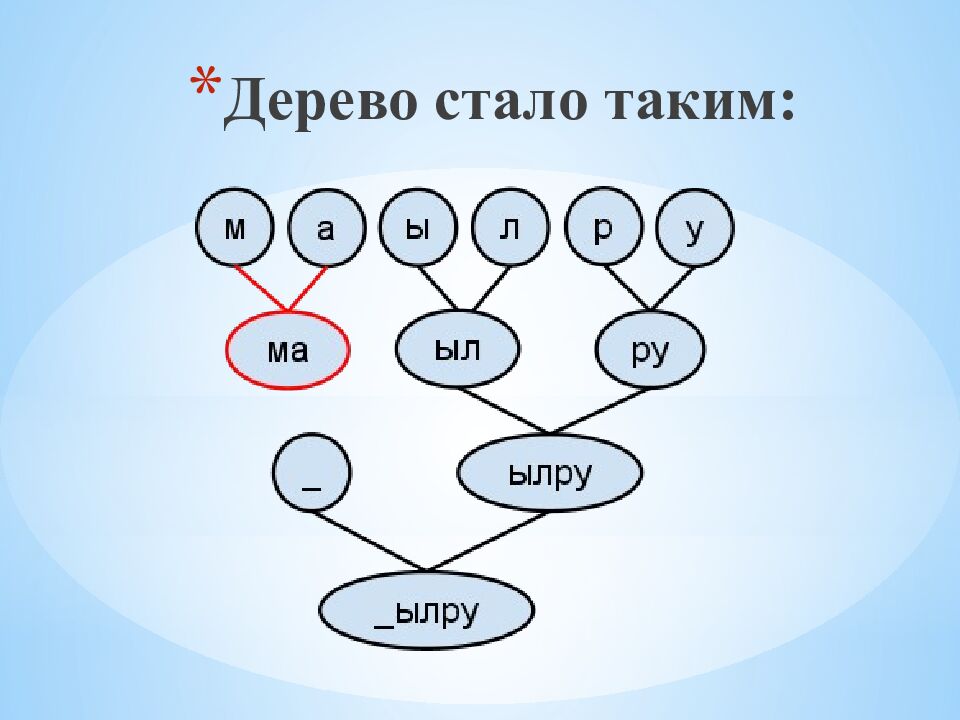
МА_ЫЛРУ 14
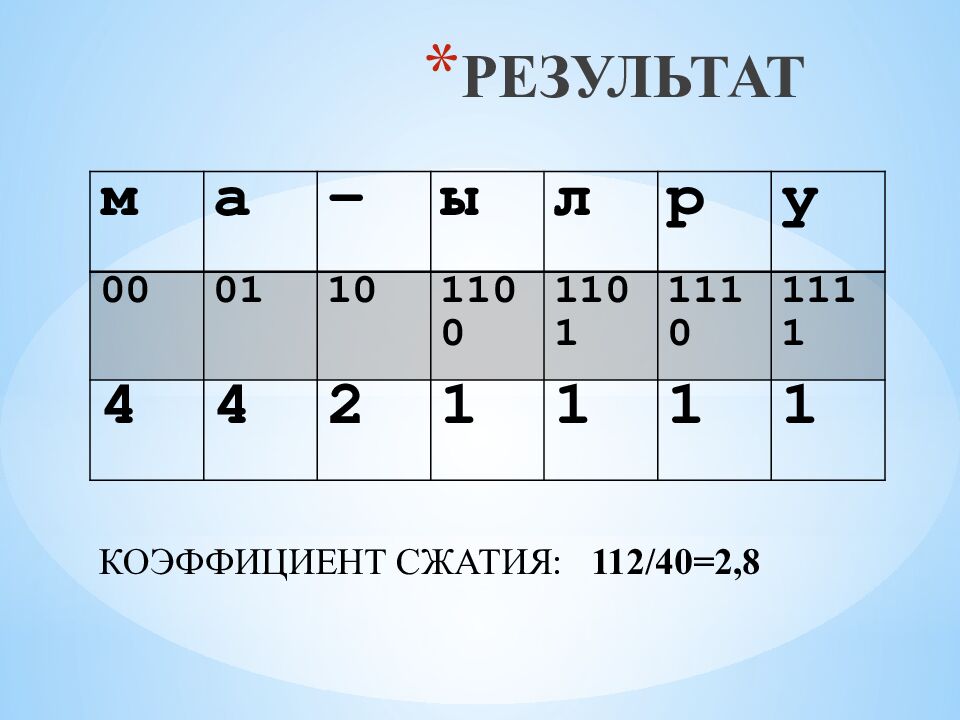
м а - ы л р у 00 01 10 1100 1101 1110 1111 4 4 2 1 1 1 1 КОЭФФИЦИЕНТ СЖАТИЯ: 112/40=2,8
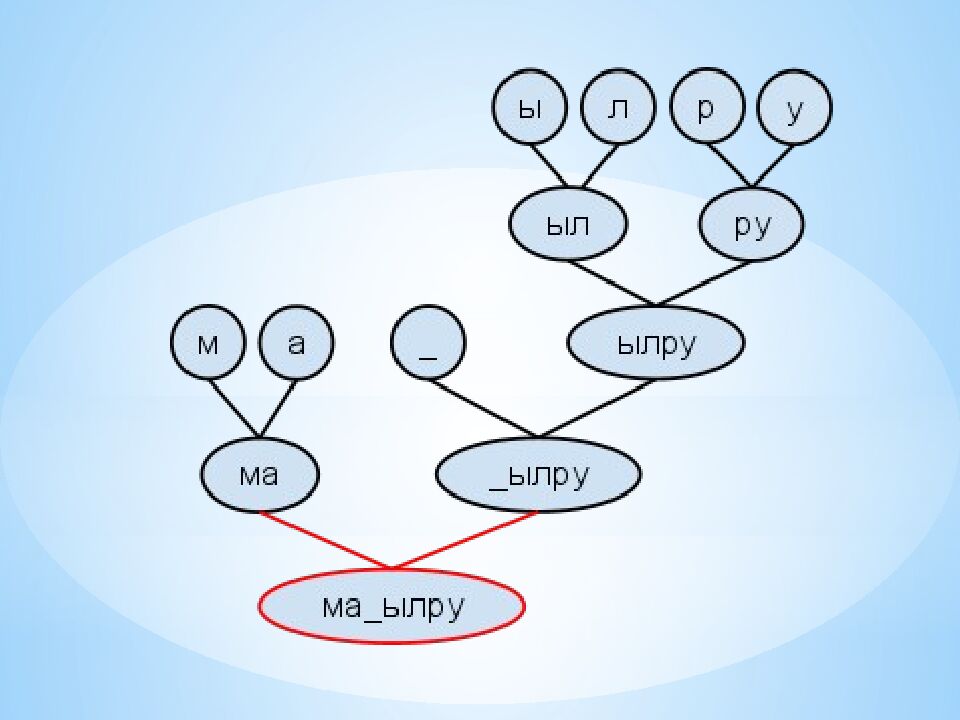
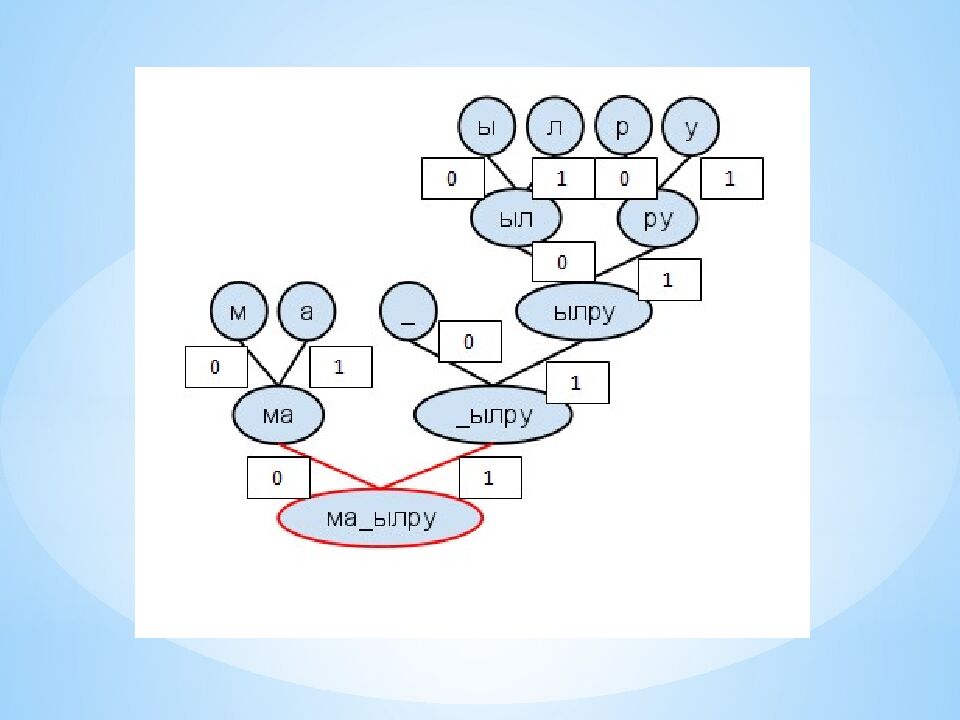
Алгоритм кода Хаффмана: 1. Символы исходного алфавита образуют вершины. Вес каждой вершины вес равен количеству вхождений данного символа в сжимаемое сообщение. 2. Среди вершин выбираются две с наименьшими весами (если таких пар несколько, выбирается любая из них). 3. Создается следующая вершина графа, из которой выходят две дуги к выбранным вершинам; одна дуга помечается цифрой 0, другая — символом 1. Вес созданной вершины равен сумме весов, выбранных на втором шаге вершин. 4. К новым вершинам применяются шаги 2 и 3 до тех пор, пока не останется одна вершина с весом, равным сумме весов исходных символов.
Математики доказали, что среди алгоритмов, кодирующих каждый символ по отдельности и целым количеством бит, алгоритм Хаффмана обеспечивает наилучшее сжатие.
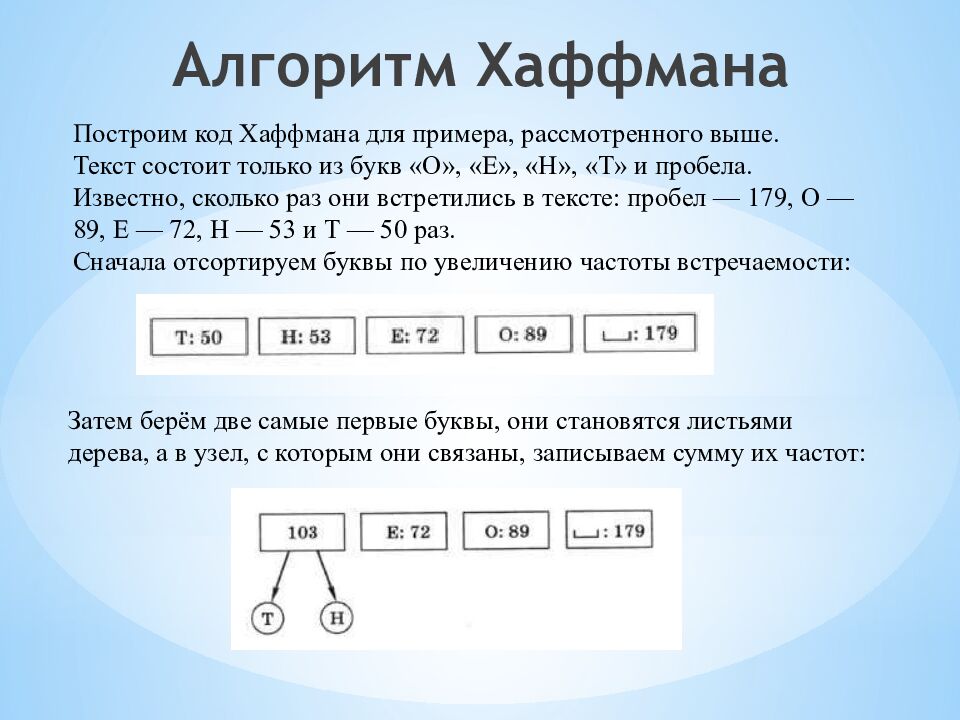
Построим код Хаффмана для примера, рассмотренного выше. Текст состоит только из букв «О», «Е», «Н», «Т» и пробела. Известно, сколько раз они встретились в тексте: пробел — 179, О — 89, Е — 72, Н — 53 и Т — 50 раз. Сначала отсортируем буквы по увеличению частоты встречаемости: Затем берём две самые первые буквы, они становятся листьями дерева, а в узел, с которым они связаны, записываем сумму их частот:
Алгоритм кода Хаффмана: 1. Символы исходного алфавита образуют вершины. Вес каждой вершины вес равен количеству вхождений данного символа в сжимаемое сообщение. 2. Среди вершин выбираются две с наименьшими весами (если таких пар несколько, выбирается любая из них). 3. Создается следующая вершина графа, из которой выходят две дуги к выбранным вершинам; одна дуга помечается цифрой 0, другая — символом 1. Вес созданной вершины равен сумме весов, выбранных на втором шаге вершин. 4. К новым вершинам применяются шаги 2 и 3 до тех пор, пока не останется одна вершина с весом, равным сумме весов исходных символов.
Таким образом, буквы, которые встречаются реже всего, получили самый длинный код. Снова сортируем буквы по возрастанию частоты, но для букв «Т» и «Н» используется их суммарная частота: Повторяем ту же процедуру для букв «Е» и «О», частоты которых оказались минимальными, и сортируем по возрастанию частот
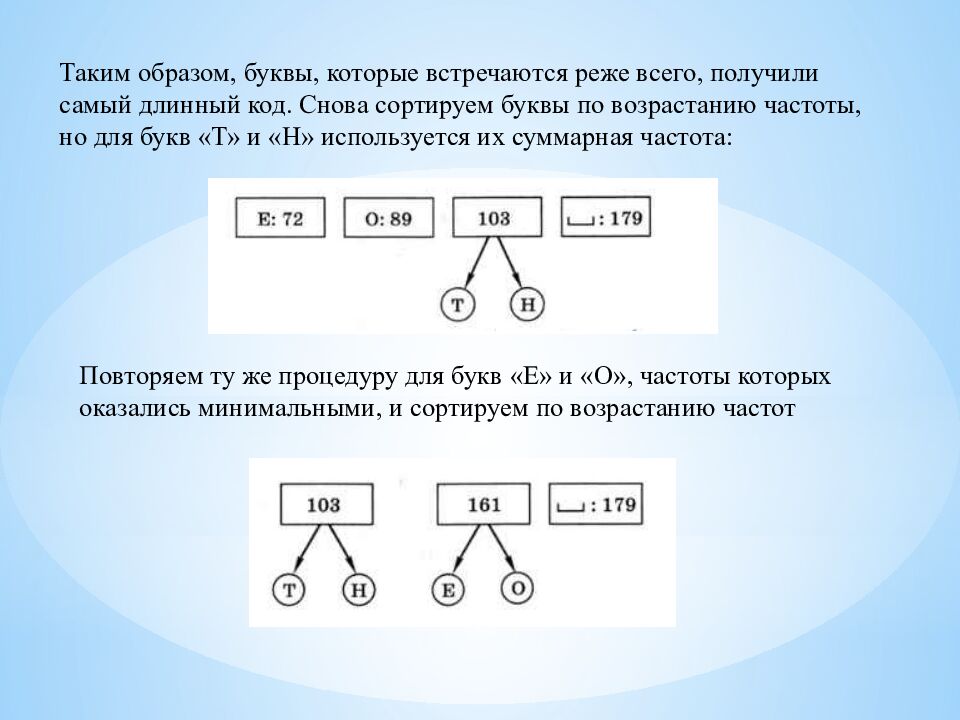
Теперь объединяем уже не отдельные буквы, а пары, и снова сортируем На последнем шаге остаётся объединить символ «пробел» с деревом, которое построено для остальных символов. У каждой стрелки, идущей влево от какого-то узла, ставим код 0, а у каждой стрелки, идущей вправо — код 1
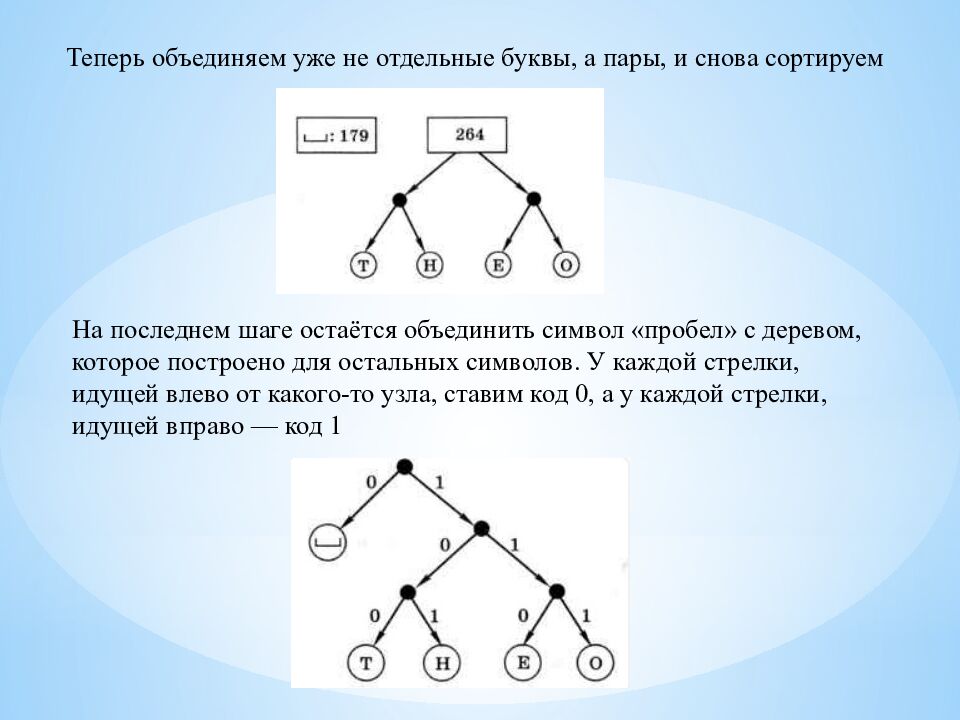
По этому дереву, спускаясь от корня к листьям-символам, получаем коды Хаффмана, обеспечивающие оптимальное сжатие с учётом частоты встречаемости символов: — О, Т — 100, О — 111, Е — 110, Н — 101. Легко проверить, что этот код также удовлетворяет условию Фано. Сравним эффективность рассмотренных выше методов. Для алфавита из 5 символов при равномерном кодировании нужно использовать 3 бита на каждый символ, так что общее число битов в сообщении равно (179 + 89 + 72 + 53 + 50) • 3 = 1329 битов. При кодировании методом Шеннона-Фано получаем 179 • 2 + 89 • 2 + 72 • 3 + 53 • 3 + 50 • 2 = 1011 битов, коэффициент сжатия составляет 1329/1011 ≈ 1,31. Использование кода Хаффмана даёт последовательность длиной 179 • 1 + 89 • 3 + 72 • 3 + 53 • 3 + 50 • 3 = 971 бит, коэффициент сжатия равен 1,37. В сравнении со случаем, когда для передачи используется однобайтный код (8 битов на символ), выигрыш получается ещё более весомым: кодирование Хаффмана сжимает данные примерно в 3,65 раза. Обратим внимание, что сжать данные удалось за счёт избыточности: мы использовали тот факт, что некоторые символы встречаются чаще, а некоторые — реже.